Prometheus: Einführung
Monitoring
Monitoring bedeutet: überwachen, beobachten, kontrollieren. In der Informatik geht es beim Monitoring darum, Informationen zum Zustand von Systemen zu erheben, auszuwerten und darauf zu reagieren. Dabei interessiert man sich nicht nur dafür, ob Systeme oder Anwendungen gerade verfügbar sind, sondern befasst sich auch mit folgenden Fragen:
- Wie viele Ressourcen werden genutzt?
- Wie schnell wird eine Anfrage beantwortet?
- Wie viele Anfragen werden bearbeitet?
- Wie viele Datenbankzugriffe löst eine Anfrage aus?
- Wie viele Benutzer verwenden eine Anwendung?
Die Beantwortung dieser Fragen gibt einem nicht nur Auskunft über den Zustand der Informatik-Infrastruktur, sondern erlaubt es auch, qualifizierte Entscheidungen zu treffen:
- Benötige ich bald neue Hardware?
- Kann ich ein System herunterskalieren?
- Lohnt sich der Betrieb einer Anwendung noch?
- Gibt es Engpässe in der Infrastruktur?
- Mit welchen Betriebskosten muss ich in Zukunft rechnen?
Monitoring dient aber nicht nur als Grundlage für geschäftliche Entscheidungen, sondern unterstützt auch die Systemadministratoren und Softwareentwickler bei ihrer täglichen Arbeit. Wer den Zustand seiner Systeme und Anwendungen einfach überblicken kann, bemerkt Probleme, bevor der Kunde und somit die Geschäftsbeziehungen zu ihm darunter leiden.
Sollte es dennoch zu einem Systemausfall kommen, kann ein Monitoring-System dies nicht nur feststellen, sondern es erlaubt auch die Benachrichtigung des entsprechenden Personals, wodurch das zugrundeliegende Problem schneller behoben worden kann – idealerweise, bevor es ein Kunde feststellt.
Zusammengefasst muss ein nützliches Monitoring-System folgendes bieten bzw. ermöglichen:
- Alerting (Alarmierung): Probleme zeitnah feststellen und zuständige Personen benachrichtigen
- Debugging (Fehlersuche): Ursachen eines festgestellten Fehlers finden
- Trending (Trendanalyse): Ressourcenbedarf und dessen Entwicklung abschätzen
Was wird überwacht?
Monitoring umfasst heutzutage nicht nur das Erheben von bestimmten Systemmetriken wie beispielsweise die Auslastung von Prozessoren, Arbeitsspeicher, Festplatten oder Netzwerkkarten. Stattdessen betrachtet man Ereignisse (Events) wie die folgenden:
- auf Protokollebene: Empfangen und Beantworten einer Anfrage
- auf Quellcodeebene: Betreten und Verlassen einer Funktion
- auf Hardwareebene: Lesen und Schreiben von Daten
Solche Ereignisse finden in einem bestimmten Kontext statt, der mithilfe von Monitoring erhoben werden kann. Bei einer HTTP-Anfrage ist dies beispielsweise die betreffende URL, auf Quellcodeebene der Name einer Funktion und bei Lese- und Schreibvorgängen der Pfad zur jeweiligen Datei.
Zu jedem Ereignis können bestimmte Metriken erhoben werden, deren zeitliche Entwicklung sich mit anderen Ereignissen vergleichen lässt. Metriken sind beispielsweise die Dauer in Millisekunden, welche die Beantwortung einer Anfrage benötigt; die Anzahl der Aufrufe einer Funktion; die Menge der gelesenen oder geschriebenen Bytes einer Datei; oder die mittlere Auslastung einer CPU in Prozent.
Solche Metriken sind nur zur Trendanalyse nützlich, wenn sie in einer gewissen Häufigkeit und für eine längere Zeitdauer erhoben und abgespeichert werden. Es lassen sich aber nicht zu jedem Kontext alle möglichen Metriken so häufig wie möglich über eine beliebig lange Zeit speichern. Dies würde nicht nur das Monitoring-System durch die hohe Verarbeitungs- und Datenmenge überlasten, sondern auch die Analyse verlangsamen und verkomplizieren. Darum ist es wichtig, dass man sich für die Ereignisse, Kontexte und Metriken entscheidet, deren Analyse bei der Alarmierung und Entscheidungsfindung wirklich hilfreich sind.
Abgrenzung zu verwandten Techniken
Monitoring hilft dabei, das Verhalten von Systemen und Anwendungen besser zu verstehen und Fehler darin aufzuspüren. Hierzu gibt es noch andere Techniken, die mit dem Monitoring zur Fehlersuche und Trendanalyse kombiniert werden können:
- Profiling: Es werden alle möglichen Ereignisse, Kontexte und Metriken erhoben, jedoch nur für einen sehr kurzen Zeitraum. Hierzu verwendet man Werkzeuge wie beispielsweise Netzwerksniffer (z.B. Wireshark).
- Tracing: Es werden nur bestimmte Ereignisse aufgezeichnet, um herauszufinden, wo welche und wie viele Ressourcen verwendet werden. Bei verteilten Systemen müssen Anfragen mit einer ID versehen werden, damit man sie über die verschiedenen Teilsysteme hinweg nachverfolgen kann.
- Logging: Es werden Ereignisse mit einigen ausgewählten Kontextinformationen festgehalten. Ein Webserver hält beispielsweise alle HTTP-Anfragen mit URL, Zeitpunkt, IP-Adresse des Anfragers, Status-Code und Beantwortungsdauer in Textdateien fest. Hierbei unterscheidet man zwischen Logs für Transaktionen, Anfragen, Anwendungen und für Debugging-Zwecke.
Das Zusammenspiel dieser verwandten Techniken kann verschiedenen Nutzen schaffen. Auf einer Dokumentverwaltung könnte sich beispielsweise folgendes ereignen:
- Monitoring: Durch die Erhebung des freien Platzes auf einer Partition wird festgestellt, dass diese bald voll ist. Ein entsprechender Alarm wird ausgelöst.
- Logging: Der benachrichtigte Systemadministrator wirft einen Blick in das Webserver-Log und bemerkt, dass bestimmte Anfragen sehr lange dauern.
- Tracing: Der zur Analyse beigezogene DevOps-Engineer stellt fest, dass diese Anfragen zu Schreibvorgängen auf die Datenbank führen.
- Profiling: Der Netzwerkspezialist erkennt, dass es Anfragen mit sehr vielen und grossen Netzwerkpaketen gibt.
Aus diesen Informationen kann man schliessen, dass ein Benutzer sehr grosse Dateien hochzuladen versucht, wofür das System nicht ausgelegt ist. Es muss eine geschäftliche Entscheidung getroffen werden: Soll man die Dateigrösse und den Speicherplatz pro Benutzer begrenzen, ein neues Preismodell erarbeiten, das System durch zusätzliche Hardwareanschaffungen hochskalieren oder die Anwendung umbauen und in die Cloud verschieben?
Sind beim Profiling, Tracing und Logging bestimmte Zeiträume, Ereignisse und Kontextinformationen interessant, konzentriert man sich beim Monitoring von Metriken auf aggregierte Informationen, z.B. die Anzahl der HTTP-Anfragen, ihre durchschnittliche Bearbeitungszeit oder die minimale und maximale Anzahl aktiver Benutzer.
Zur Berechnung dieser aggregierten Informationen müssen aber zunächst die einzelnen Metriken für eine bestimmte Zeitdauer erhoben und abgespeichert werden. Nach der Aggregierung können die einzelnen Metriken gelöscht und nur noch die aggregierten Daten gespeichert werden. Auch aggregierte Daten müssen nur für eine bestimmte Periode aufbewahrt werden. Dadurch kann der Speicherbedarf über die Zeit hinweg tief gehalten werden.
Prometheus
Prometheus ist ein Monitoring-System für Anwendungen und Infrastruktur. Es sammelt Metriken ein, speichert diese, erlaubt den Zugriff darauf und ermöglicht so das Erstellen von Graphen und Dashboards zur Überwachung. Es können Regeln definiert werden, nach denen Personen alarmiert werden, die sich dann um das jeweilige Problem kümmern können. Prometheus richtet sich an Systemadministratoren, DevOps-Engineers und Applikationsentwickler.
Bei Prometheus handelt es sich um eine noch relativ junge aber bereits gut etablierte Monitoring-Lösung, die seit 2012 in der Programmiersprache Go entwickelt wird und mittlerweile in Version 3 vorliegt. Die Lösung ist unter einer Open-Source-Lizenz (Apache 2.0) für verschiedenste Betriebssysteme frei verfügbar. Prometheus ist Mitglied der Cloud Native Computing Foundation (CNCF).
Mit Prometheus lassen sich sowohl eigens entwickelte Anwendungen durch die Einbindung einer Client-Library als auch Drittanwendungen durch die Integration mit einem entsprechenden Exporter monitoren. Viele Programmiersprachen (z.B. Go, Java, C#, Python) und Server-Anwendungen (HAProxy, MySQL, PostgreSQL, Redis) bieten entsprechende Integrationen.
Metriken können über ein einfaches Textformat an Prometheus übermittelt werden. Jede Messreihe wird anhand eines Namens und mit einer Reihe sogenannter Labels (Schlüssel-Wert-Paare) identifiziert. Diese Messreihen können mit einer eigenen Abfragesprache namens PromQL abgefragt werden. Mithilfe solcher Abfragen lassen sich Dashboards in Visualisierungslösungen wie Grafana und Perses umsetzen.
Mithilfe von PromQL können auch Alarme definiert werden. Alles, was sich grafisch darstellen lässt, kann auch als Grundlage für einen Alarm dienen. Alarme müssen so nicht für einzelne Metriken, sondern können gemäss definierter Regeln ausgelöst werden.
Prometheus verfügt über einen Service-Discovery-Mechanismus, womit Metriken der zu monitorenden Systeme automatisch aufgespürt und ausgelesen werden können. Dies erspart die Konfiguration für jede einzelne Metrikquelle, was gerade im Kontext des Cloud Computings sehr hilfreich ist. Hierbei spricht man oft vom Gegensatz pets vs. cattle: d.h. man unterscheidet zwischen «Haustieren» (Systeme, denen man Namen vergibt und lange pflegt) und «Vieh» (kurzlebige Systeme, die man bei Bedarf erstellt und dann wieder loswird).
Mit nur einer Binär- und einer Konfigurationsdatei ist Prometheus eine sehr schlanke Lösung, die sich sehr einfach installieren und in Betrieb nehmen lässt. Prometheus ist keine Infrastruktur-Management-Plattform, sondern wird in bestehende Infrastruktur integriert.
Systemübersicht
Die folgende Grafik bietet einen Überblick über die Architektur von Prometheus, das aus verschiedenen Kernkomponenten (dunkel dargestellt) besteht, womit sich externe Systeme (hell dargestellt) anbinden lassen. Hierzu dienen Client-Libraries und Exporters (halbdunkel dargestellt), die entweder vom Prometheus-Projekt selber oder von Drittparteien bereitgestellt werden.
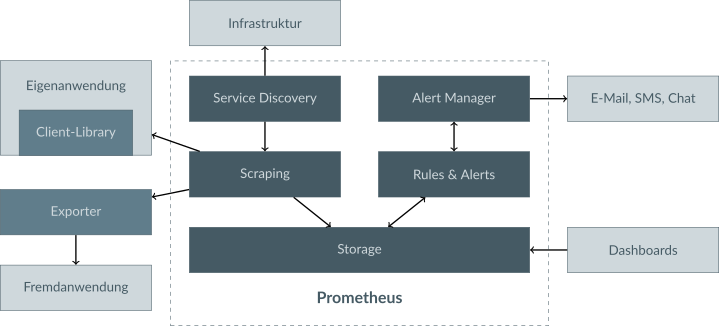
Mit Service Discovery findet Prometheus die Systeme in der Infrastruktur, von denen es Metriken einsammeln kann. Diese werden mittels Scraping per HTTP eingesammelt und im Storage abgespeichert. Hierzu kommt ein Pull-Mechanismus zum Einsatz, d.h. Prometheus sammelt die Metriken ein. (Im Gegensatz dazu würden bei einem Push-Mechanismus die Systeme die Metriken selbständig an Prometheus senden.) Das Scraping findet einmal ca. alle 10-60 Sekunden statt.
Die Metriken werden im Storage gespeichert. Hierbei handelt es sich um eine spezielle Datenbank, die lokal läuft. Dieser Datenspeicher lässt sich nicht über verschiedene Systeme verteilen, ist aber schnell genug, um Millionen von Metriken pro Sekunde zu schreiben. (Hierzu empfiehlt sich der Einsatz einer SSD.)
Eigene Anwendungen können mit einer Client-Library ausgestattet werden, welche das Herausschreiben von Metriken erlaubt. Betreibt man hingegen eine Fremdanwendung, muss für diese eine als Exporter bezeichnete Schnittstelle bereitgestellt werden, womit die Metriken aus der Anwendung extrahiert werden können.
Der Alert Manager erlaubt die Definition von Regeln zur Auslösung von Alarmen. Die Benachrichtigung der entsprechenden Person findet dann über ein externes System statt, sodass der Alarm über E-Mail, per SMS, per Chat usw. erfolgen kann. Prometheus löst selber keine Benachrichtigungen aus, sondern integriert entsprechende Systeme.
Mit PromQL können einerseits Rules & Alerts definiert werden. Hierbei handelt es sich um die Regeln, nach denen der Alert Manager Benachrichtigungen auslöst. Andererseits erlaubt PromQL die Definition von Graphen, womit sich sogenannte Dashbaords aufbauen lassen. Diese bieten einen grafischen Überblick über verschiedene aggregierte Metriken.
Da Prometheus ein Metrik-basierendes System ist, eignet es sich nicht zum Festhalten von Event Logs oder für feingranulare Daten zu einzelnen Events wie E-Mail-Adressen, IP-Adressen oder Benutzernamen. Prometheus bietet auch kein Langzeitarchiv für historische Metriken.