Valkey: Einführung
In der Informatik bildet man nicht nur Objekte aus der realen Welt wie z.B. Personen oder Adressen ab, sondern auch Teilaspekte dieser Objekte, z.B. eine Liste bekannter Vornamen oder eine Zuordnung von Postleitzahlen zu Orten. Solche Sachverhalte bildet man durch sogenannte abstrakte Datentypen ab, die persistent in verschiedenen Arten von Services verwaltet werden können.
Diese abstrakten Datentypen müssen für einen konkreten Einsatzzweck genauer spezifiziert werden. Verwendet man eine Liste, muss man sich bewusst sein, welchen Datentyp die einzelnen Listenelemente haben. Verwendet man eine Map, muss man für die Schlüssel und die Werte einen Datentyp definieren.
Abstrakte Datentypen
Im Gegensatz zu einem konkreten Datentyp wie einer Adresse (mit Vor- und Nachname, Strasse, PLZ und Ort) sind abstrakte Datentypen weniger spezifisch auf ein bestimmtes Einsatzgebiet eingeschränkt. Man kann sie sehr flexibel für verschiedenste Probleme verwenden, wobei es wichtig ist, für das vorliegende Problem die richtige Datenstruktur zu wählen.
Möchte man beispielsweise die Hierarchie eines Dateisystems oder ein Organigramm einer Firma abbilden, eignet sich hierzu ein Baum (engl. Tree) als abstrakter Datentyp. Möchte man hingegen bloss eine Reihe von Messwerten abspeichern, ist ein Array oder eine Liste der geeignete abstrakte Datentyp. Sind die Elemente einer Liste bzw. eines Arrays eindeutig, und ist deren Reihenfolge nicht relevant, kann man diese als eine Menge (engl. Set) abbilden. Möchte man Werte nach einem bestimmten Schlüssel nachschlagen können, sind Maps bzw. Hashes die richtige Wahl.
Arrays
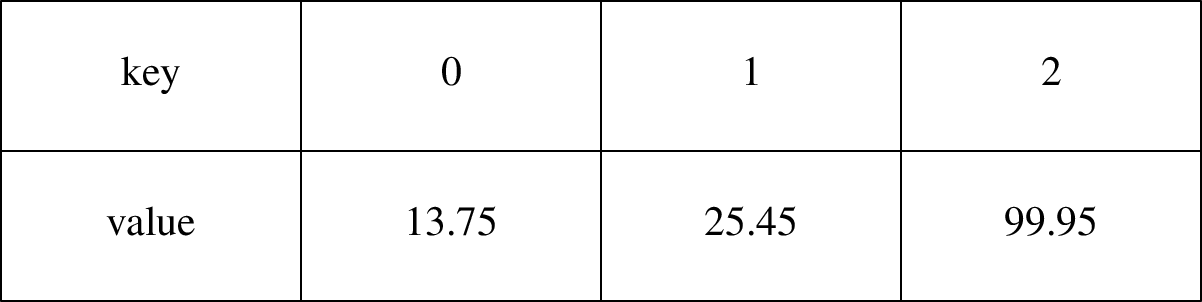
Ein Array ist eine Datenstruktur, welche ihre Elemente unter Indizes von [0..n[ ablegt, d.h. 0 (inklusiv) ist der kleinste Index, n (exklusiv, d.h.n-1) ist der höchste Index.
Listen
Im Gegensatz zu Arrays werden Listen nicht über einen Index geordnet, sondern speichern zu jedem Element eine Referenz auf dessen Nachfolger ab:
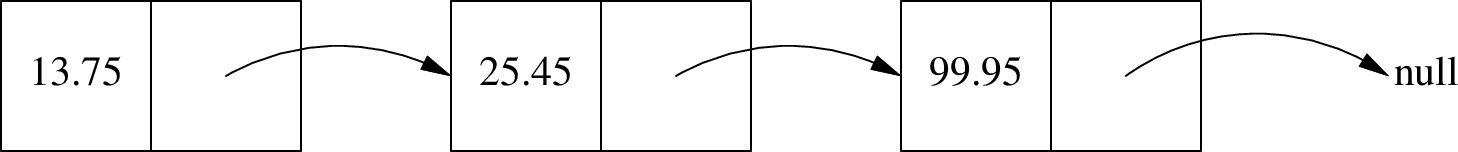
Das letzte Element einer Liste verweist auf null um zu signalisieren, dass die
Liste zu Ende ist.
Vergleich Arrays und Listen
Das gleiche Problem kann sowohl mit Arrays als auch mit Listen gelöst werden,
es gibt aber massive Unterschiede in der Performance für verschiedene
Operationen auf den beiden Datenstrukturen. Angenommen, man möchte eine
Datenstruktur mit n Elementen verwalten, ergeben sich dadurch folgende
Unterschiede:
| Operation | Schritte (Array) | Schritte (Liste) |
|---|---|---|
| Zugriff auf bestimmtes Element | 1 | durschnittlich: n/2 |
| vorne anfügen | n | 1 |
| hinten anfügen | 1 oder n+1 | 1 oder n+1 |
- Beim Anfügen an ein Array benötigt man einen Schritt, wenn das Array hinten
noch freie Plätze reserviert hat. Hat das Array keine Kapazität für weitere
Elemente, muss ein grösseres Array erstellt werden, in welches dann alle
Einträge des bestehenden Arrays kopiert werden müssen. Dadurch werden
n+1Schritte benötigt. - Beim Anfügen an eine Liste kommt es darauf an, ob eine Referenz zum letzten
Element gespeichert wird. Ist eine solche Referenz vorhanden, kann ein
weiteres Element in einem Schritt hinzugefügt werden. Andernfalls benötigt man
n+1Schritte, da man zuerst noch innSchritten das Ende der Liste suchen muss.
Mengen (Sets)
Eine Menge bzw. ein Set ist eine ungeordnete Ansammlung von eindeutigen Elementen. Betrachten wir die folgenden beiden Mengen A und B:
- $ A = \{1, 2, 3, 4, 5\} $
- $ B = \{2, 4, 6, 8, 10\} $
Auf diese Mengen können verschiedene Mengenoperationen angewendet werden:
- Schnittmenge: $ A \cap B = \{2, 4\} $
- Vereinigungsmenge: $ A \cup B = \{1, 2, 3, 4, 5, 6, 8, 10 \} $
- Differenz (“A ohne B”): $ A - B = \{1, 3, 5\} $
- Differenz (“B ohne A”): $ B - A = \{6, 8, 10\} $
Maps bzw. Hashes
Eine Map oder ein Hash ist eine Datenstruktur, die arbiträre d.h. beliebige Indizes unterstützt:
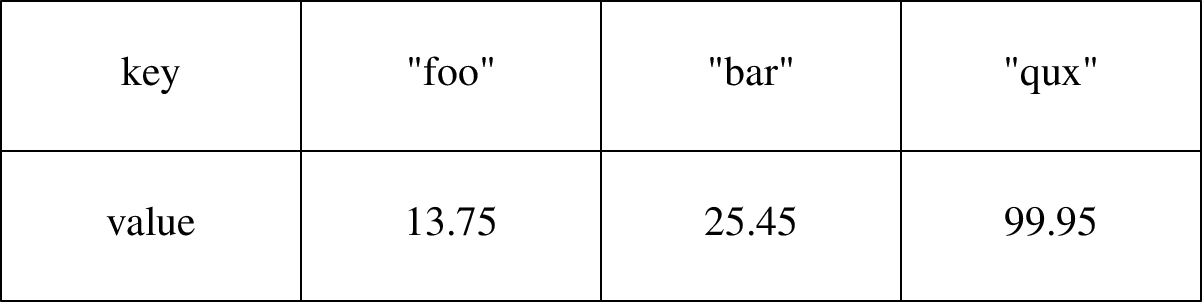
Die Indizes müssen auch hier eindeutig sein, aber keinem bestimmten Schema folgen. Die Indizes kann man sich als eine Menge (Set) vorstellen, in welcher alle Elemente eindeutig sein müssen.
Maps haben in verschiedenen Programmiersprachen verschiedene Bezeichnungen: Map (Go), Dictionary (Python), Hash (Ruby), Table (Lua), assoziatives Array (PHP) usw.
Valkey: Ein Key-Value-Store
Valkey ist ein sogenannter Key-Value-Store, der Werte (Values) unter eindeutigen Schlüsseln (Keys) abspeichert. Valkey ist ein Fork von Redis, was eine Abkürzung für Remote Dictionary Service ist: Es handelt sich also um einen Dienst, den man als (entferntes) “Wörterbuch” verwenden kann. Dies soll heissen, dass man in diesem Service Werte anhand eines Schlüssels ablegen und nachschlagen kann. Redis ist somit als eine grosse Map zu verstehen.
Valkey als Nachschlagewerk
In Valkey müssen die Schlüssel eindeutig sein, damit man sie zum Nachschlagen von Werten verwenden kann. Werte dürfen hingegen mehrmals die gleichen vorkommen. Hierzu einige Beispiele:
| Schlüssel | Wert |
|---|---|
balance | 25471.93 |
127.0.0.1 | localhost |
ipv4 | 195.347.52.9 |
Joe Doe | +019425287164 |
started | 2021-12-29T19:35:12.15.632+00:00 |
Es gibt verschiedene Systeme, die wie ein solches Nachschlagewerk funktionieren, beispielsweise:
- das Domain Name System (DNS) zum Nachschlagen von IP-Adressen (Values) anhand von Domainnamen (Keys)
- eine ARP-Tabelle zum Nachschlagen von MAC-Adressen (Values) anhand von IPv4-Adressen (Keys)
- ein Telefonbuch zum Nachschlagen von Telefonnummern (Values) anhand von Namen (Keys)
- ein Lexikon zum Nachschlagen von Bedeutungen (Values) anhand von Begriffen (Keys)
- ein Dateisystem zum Ablegen von Dateien (Values) unter bestimmten Pfaden (Keys)
Datentypen
Valkey ist ein Datenspeicher für abstrakte Datentypen, d.h. die darin gespeicherten Daten folgen keinem strengen Schema wie bei relationalen Datenbanken, aber weisen gewisse Strukturen auf. Es werden u.a. die folgenden Datentypen unterstützt, welche entprechende Gegenstücke in Programmiersprachen haben:
| Programmiersprachen | Valkey |
|---|---|
| Primitive Datentypen | String |
| Zeichenketten | String |
| Arrays, Listen | List |
| Maps, Dictionaries, Hashes | Hash |
| Mengen | Set |
Valkey ist also ein Datenspeicher für Datenstrukturen und funktioniert selber wie eine grosse Map mit (eindeutigen) Schlüsseln und dazu zugeordneten Werten.
Persistente Datenspeicherung
Valkey kann Daten auf verschiedene Arten speichern:
- Das RDB-Format (“Redis Database”) speichert die Datenbank als Zustand in einer Datei ab. Dieses Format ist sehr kompakt, schnell im Zugriff und eignet sich sehr gut für Datensicherungen (Backups). Änderungen werden nicht in Echtzeit geschrieben, sondern nur periodisch, wodurch Datenverluste auftreten können.
- Analogie: Das aktuelle Saldo eines Bankkontos, wovon man aber nicht weiss, welche Zahlungsein- und -ausgänge zu diesem Saldo geführt haben.
- Das AOF-Format (“Append-only File”) speichert die Datenbank als Transaktionslog in einer Datei ab. Dabei wird jede einzelne Operation abgespeichert, sodass es nachvollziehbar ist, was mit der Datenbank passiert ist. Dieses Format bietet Nachvollziehbarkeit und Sicherheit, benötigt aber viel Platz und ist langsam, da der aktuelle Zustand anhand der abgespeicherten Transaktionen berechnet werden muss.
- Analogie: Die Zahlungsein- und -ausgänge eines Bankkontos, die aufsummiert werden müssen, damit man das Saldo zu einem bestimmten Zeitpunkt herausfinden kann.
Es ist auch möglich, beide Formate zu aktivieren. Dadurch hat man die Vorteile beider Formate, benötigt aber auch mehr Speicherplatz und opfert zusätzlich Performance, da einerseits jede Transaktion (AOF) und andererseits der aktuelle Zustand periodisch (RDB) gesichert werden muss.
Möchte man Valkey als schnellen Zwischenspeicher (Cache) einsetzen, ist es auch möglich, keines der beiden Formate zu verwenden. Wird Valkey neu gestartet, sind die Daten unwiderruflich verloren. (In solchen Einsatzszenarien lassen sich aber die Daten einfach neu berechnen.)
Standardmässig ist Valkey so konfiguriert, dass es das RDB-Format verwendet. Bei der Auswahl der Speicherart kann man sich folgendes überlegen:
- Möchte man den aktuellen Zustand kennen, sollte man das RDB-Format verwenden.
- Möchte man wissen, wie es zum aktuellen Zustand gekommen ist, sollte man das AOF-Format verwenden.
- Möchte man beides wissen, sollte man das RDB- und das AOF-Format verwenden.
- Möchte man Valkey nur als Cache ohne Persistenz einsetzen, kann man Valkey ohne RDB/AOF betreiben.
Der Abschnitt Persistenz der Valkey-Dokumentation enthält weiterführende Informationen zu diesen Formaten, deren Vor- und Nachteilen sowie zur Konfiguration.
Valkey: Praktische Verwendung
Der Valkey-Server kann über verschiedene Sprachanbindungen aus einer Programmiersprache heraus angesprochen werden. Für den interaktiven Gebrauch steht das Kommandozeilenwerkzeug valkey-cli zur Verfügung. Eine solche Session kann folgendermassen aussehen:
- Die Session wird mit dem Befehl
valkey-cligeöffnet. - Mit
PINGwird geprüft, ob die Verbindung zum Server funktioniert. (Es kommtPONGzurück.) - Mit
SETwird ein Eintrag (key:name, value:John) geschrieben. - Mit
KEYS *werden alle vorhandenen Schlüssel aufgelistet (aktuell nurname). - Mit
DELwird der Schlüsselnamegelöscht. - Mit
EXISTSkann man das Vorhandensein eines Schlüssels überprüfen (0heisst “negativ”, d.h. der Schlüsselnameexistiert nicht (mehr)).
Befehlstruktur
Valkey kennt über 400 Befehle. Diese muss man nicht auswendig kennen. Es ist aber hilfreich, sich mit folgenden Regeln durch die Befehlsstruktur orientieren zu können:
- Befehle haben ein Präfix. Dieses richtet sich nach der Datenstruktur, auf welcher der Befehl operiert:
- List:
Lbzw.Rfür Operationen am linken bzw. rechten Listenende - Sets:
S - Hashes:
H - Sorted Sets:
Z
- List:
- Die Befehle haben keine, einen oder mehrere (teils optionale) Parameter:
FLUSHALL: keine ParameterGET key: ein ParameterSET key value: zwei ParameterHGET key field1 value1 [field2 value2 …]: beliebig viele Parameter
Grundlegende Befehle
Die folgenden Befehle werden im interaktiven Umgang mit Valkey sehr häufig verwendet. Ihren Gebrauch sollte man beherrschen:
PING: Verbindung testen (gibtPONGaus, wenn die Verbindung steht)HELP: Hilfe ausgeben, z.B. zu einem Befehl- Beispiel:
HELP PING
- Beispiel:
AUTH: Interaktive Authentifizierung mit PasswortFLUSHALL: Löscht alle EinträgeKEYS: Schlüssel gemäss Muster anzeigenKEYS *: listet alle Schlüssel auf
EXISTS: Prüft, ob ein Schlüssel existiertTYPE: Gibt den Datentyp des Werts von einem Schlüssel ausSAVE: Persistente Speicherung forcieren
Befehle für einfache Werte
Der einfachste Einsatz von Valkey ist das Verwalten einfacher Werte, d.h. von Schlüssel-Wert-Paaren.
SET: Ein Schlüssel/Wert-Paar definierenMSET: Mehrere Schlüssel/Wert-Paare gleichzeitig definieren
GET: Wert anhand eines Schlüssels auslesenDEL: Eintrag entfernenRENAME: Schlüssel umbenennen
Strukturierte Schlüsselnamen
Schlüsselnamen können gemäss einer selbst gewählten Konvention strukturiert werden. Hierbei werden Teile des Schlüssels durch einem Punkt oder durch einen Doppelpunkt voneinander getrennt. (Diese Zeichen haben keine besonderen Bedeutungen, sondern dienen einfach zur optischen Strukturierung der Schlüssel.)
Beispiele:
Mithilfe der *-Wildcard können verschiedene Schlüssel anhand eines Musters ausgelesen werden, z.B. die Namen aller Angestellter:
Möchte man alle Schlüssel zu einem bestimmten Angestellten in Erfahrung bringen, kann man die *-Wildcard an der entsprechenden Stelle verwenden:
Befehle für Hashes
Ein Hash speichert Schlüssel/Wert-Paare ab und ist mit dem Map- bzw. Hash-Datentyp verschiedener Programmiersprachen vergleichbar, erlaubt aber keine Verschachtelung. (Alle Schlüssel und Werte sind Strings.)
Die wichtigsten Befehle für Hashes sind:
HSET: Definiert einen Hash mit Schlüssel/Wert-PaarenHGET: Gibt ein Feld zu einem Hash ausHGETALL: Gibt alle Feldnamen und -Werte zu einem Hash ausHKEYS: Gibt die Feldnamen zu einem Hash ausHVALS: Gibt die Werte zu einem Hash ausHDEL: Löscht ein Feld von einem Hash (aber nicht den Hash selber)HSETNX: Setzt ein Feld von einem Hash, sofern es noch nicht definiert ist
Die Struktur von einem zusammengesetzten Objekt muss nicht über den Namen codiert werden, sondern kann über einen Hash gelöst werden:
Hashes kennen kein Schema, wie es bei Tabellen relationaler Datenbanken zum Einsatz kommt. Man kann sich also nicht darauf verlassen, dass ein Hash bestimmte Felder enthält!
Export im CSV- und JSON-Format
Valkey erlaubt den Export von Daten ins CSV-Format:
Ausgabe:
Ab Valkey-Version 7, die auf den VMs vorinstalliert ist, lassen sich auch JSON-Datenstrukturen in Valkey verwalten und daraus exportieren:
Ausgabe:
Diese JSON-Datenstrukturen können dann mithilfe anderer Technologien weiterverarbeitet werden.